GPT-4 frôle l'expertise des médecins en ophtalmologie
Une étude récente montre que GPT-4 d'OpenAI rivalise avec les médecins experts lors d'examens ophtalmologiques.
Par Anthony Rodier
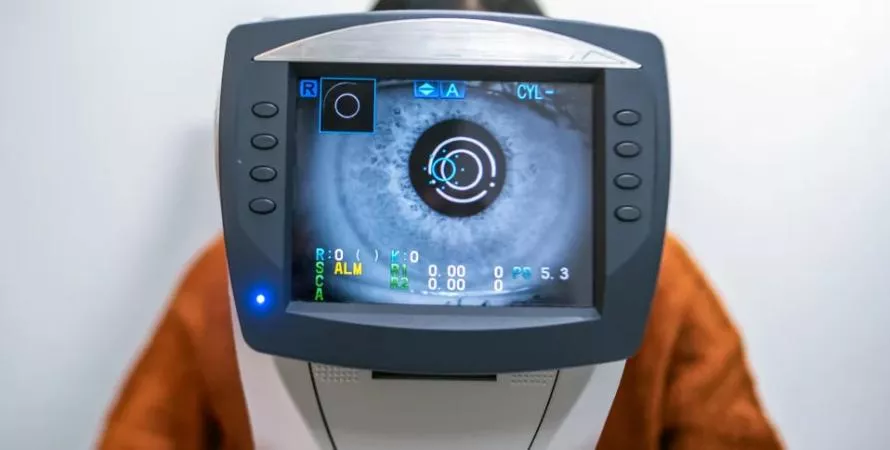
C'est assez impressionnant de voir où la technologie nous mène, surtout quand on parle de santé. Dernièrement, le Financial Times a révélé une étude de l'Université de Cambridge qui montre que GPT-4, le petit dernier d'OpenAI, se débrouille presque aussi bien que des experts en ophtalmologie. Oui, vous avez bien lu.
Dans cette étude, publiée dans PLOS Digital Health, des chercheurs ont mis à l'épreuve GPT-4, ainsi que son prédécesseur GPT-3.5, le PaLM 2 de Google, et le LLaMA de Meta, avec un quiz de 87 questions à choix multiples. Cinq ophtalmologistes experts, trois internes et deux médecins juniors non spécialisés ont passé le même examen fictif. Les questions étaient tirées d'un manuel destiné à entraîner les internes sur des sujets allant de la sensibilité à la lumière aux lésions. Les contenus n'étant pas disponibles publiquement, on peut supposer que les modèles de langage ne les connaissaient pas à l'avance.
GPT-4 a carrément surpassé les internes et les juniors, en répondant correctement à 60 questions sur 87. Ça, c'est nettement mieux que la moyenne des juniors, qui ont eu 37 bonnes réponses. Le modèle a même devancé les trois internes qui ont eu une moyenne de 59,7 bonnes réponses. Même si un expert a répondu juste à seulement 56 questions, la moyenne des cinq était de 66,4 bonnes réponses, restant ainsi devant GPT-4. PaLM 2 a eu 49, GPT-3.5 a eu 42 et LLaMa a fini dernier avec 28, en dessous des juniors.
Ces résultats sont encourageants, mais ils amènent aussi leur lot de risques et d'interrogations. Les chercheurs soulignent que l'étude couvrait un nombre limité de questions, particulièrement dans certaines catégories, ce qui peut affecter la précision des résultats. De plus, il faut rester vigilant car les modèles de langage ont parfois tendance à inventer des réponses. C'est une chose de se tromper sur un fait mineur, mais c'est tout autre chose de diagnostiquer à tort une cataracte ou un cancer. Comme souvent avec ces technologies, il manque encore de finesse et de précision, ce qui peut mener à des erreurs.